Informatik 11 GK/LK: A Relationale Datenbanksysteme - Herr Hempel
Abschnittsübersicht
-
 Herzlich willkommen im Kurs Informatik 11 A zum Thema Relationale Datenbanksysteme!
Sie werden im Themenfeld Relationale Datenbanksysteme untersuchen, wie umfangreiche Datenbestände strukturiert gespeichert, verwaltet und gezielt ausgewertet werden können. Dabei lernen Sie grundlegende Modelle und Methoden der Informatik zur Analyse, Modellierung und Lösung von Problemen kennen.
Dieser Moodle-Kurs begleitet den Unterricht. Sie finden hier Tafelbilder, Aufgaben, Dateien, Arbeitsblätter sowie Lösungen. Die Unterlagen werden nach der Unterrichtsstunde freigegeben.
Stand: 15.08.2026 - Der Kurs wird aktuell im ersten Halbjahr des Schuljahres 2026/27 wieder gepflegt.
-
-
Richard Wossidlo gilt als Urvater der mecklenburgischen Volkskunde. Zeit seines Lebens sammelte er niederdeutsche Wörter, Redewendungen und Volksüberlieferungen. Wossidlo hielt die gesammelten Informationen auf Zetteln fest und ordnete diese in Karteikästen. Dieses Zettelkastensystem wurde mittlerweile von Informatikern digitalisiert und steht allen als Wossidlo-Archiv zur Verfügung.

Richard Wossidlo vor seinem Zettelkasten - Quelle: SchularchivFür die Digitalisierung mussten sich die Informatiker beispielsweise folgende Fragen stellen:
- Wie können die Informationen aus einem Zettelkasten so digital gespeichert werden, dass sie gezielt durchsucht werden können?
- Wie lassen sich solche Datenmengen strukturieren?
- Wie kann man Informationen finden?
Eine Möglichkeit, Daten zu strukturierten, ist die Nutzung von Tabellen. In den Klassen 7 und 8 haben wir uns intensiv mit der Tabellenkalkulation beschäftigt und Daten in Tabellen verwaltet und Werte berechnet. Eine Tabellenkalkulationssoftware scheint also ein ideales Werkzeug zum Speichern und Verwalten großer Datenmengen zu sein.
Prüfen wir diese These anhand einer Bücherverwaltung.
-
Lösungen Arbeiten mit der Büchereiverwaltungsdatei Textseite
-
Grundsätzlicher Aufbau von Datenbanksystemen
Das Bibliotheksbeispiel zeigt anschaulich, dass es für eine effektive Arbeit mit den Daten zwischen dem Nutzer und den Datentabellen eine Schnittstelle oder besser Software geben muss, die die Kommunikation vereinfacht. Diese Überlegung führt uns zum Aufbau von Datenbanksystemen.
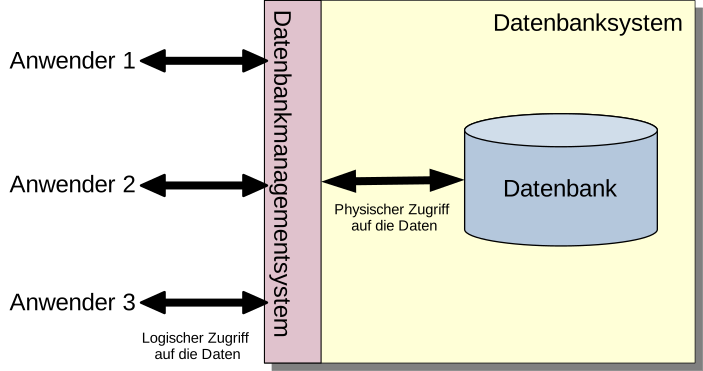
Ein Datenbanksystem (DBS) setzt sich aus einer Datenbasis und einem Datenbankmanagementsystem (DBMS) zusammen. DBMS ist die Software zur Definition, Verwaltung, Änderung und Abfrage der Daten. Es vermittelt den Zugriff von Anwendungen und Benutzern auf die Datenbank und dient der effizienten Speicherung und Abfrage der strukturierten Daten. Die Datenbank enthält neben den reinen Nutzdaten auch die zur Verwaltung des gesamten Systems nötigen Metadaten. Metadaten beschreiben beispielsweise Tabellen, Attribute, Datentypen, Schlüssel und Zugriffsrechte.
-
 Die Aufgabe mit der Bibliotheksverwaltung hat ergeben, dass sich die Daten übersichtlich in Tabellen strukturieren lassen. Das relationale Datenbankmodell beschreibt die Datenstruktur mithilfe von Tabellen, die Relationen genannt werden. Das Modell geht auf Edgar F. Codd zurück, der es 1970 während seiner Tätigkeit bei IBM veröffentlichte und für seine Arbeiten 1981 mit dem Turing-Award ausgezeichnet wurde.
Bild: (c) IBM, Quelle Wikipedia, https://en.wikipedia.org/wiki/File:Edgar_F_Codd.jpg
Folgende Begriffe prägen das Modell:

Das Schema dieser Relation lässt sich in der Kurzschreibweise Person (PNr, Name, Vorname, PLZ, Ort) notieren.
Ziel unseres Kurses ist es, solche Strukturen selbstständig aus Anforderungen an eine Datenbank zu entwickeln. Zuvor untersuchen wir jedoch, wie Informationen gezielt und effizient aus Relationen ermittelt werden können.
-
-
-
Bearbeiten wir nun ein zentrales Problem bei der Verwaltung von Daten: Wie können wir gezielt Informationen aus einer Datenbank gewinnen? Dazu verwenden relationale Datenbankmanagementsysteme die Datenbanksprache SQL. Wir lernen sie zunächst spielerisch kennen – auf geht es nach SQL Island!
-
Lösungen SQL-Island Datei
-
Lösungen SQL-Island (Video) Link/URL
-
 Mithilfe der Datenbanksprache SQL können Datenstrukturen definiert sowie Daten abgefragt und verändert werden.
Diese Sprache wurde in den 1970er Jahren von Donald D. Chamberlin (ACM Software System Award 1988) und Raymond F. Boyce, basierend auf den Arbeiten von Edgar F. Codd (Turing Award 1981) bei IBM im Rahmen eines Forschungsprojektes entwickelt und 1987 international standardisiert. Im Gegensatz zu den bisher im Unterricht behandelten imperativen Programmiersprachen beschreibt eine SQL-Abfrage, welches Ergebnis gesucht wird, nicht jedoch die einzelnen Verarbeitungsschritte, mit denen das Datenbankmanagementsystem dieses Ergebnis erzeugt. SQL ist daher eine deklarative Sprache.
SQL-Anweisungen lassen sich nach ihrem Zweck in verschiedene Gruppen einteilen. Die genaue Einteilung unterscheidet sich teilweise zwischen den Darstellungen. Für unseren Unterricht unterscheiden wir zunächst:
- DDL – Data Definition Language
Befehle zur Definition von von Datenbankstrukturen - DML – Data Manipulation Language
Befehle zur Datenmanipulation - DQL - Data Query Language
Befehle zur Abfrage von Daten
Zunächst arbeiten wir mit bereits vorhandenen Datenbanken. Deshalb beschäftigen wir uns zuerst mit der Abfrage von Daten.
Bild: Dicklyon, CC BY-SA 4.0 via Wikimedia Commons
- DDL – Data Definition Language
-
Datenabfragen mit SQL
GK: SELECT-Befehl
Die SQL-Abfrage erfolgt mit dem Befehl SELECT unter Angabe von bis zu fünf Komponenten. Die allgemeine Syntax hat die Gestalt:
SELECT [DISTINCT] * | <Attributliste>
FROM <Tabelle oder Verbund>
[WHERE <Boolescher Ausdruck]
[ORDER BY <Attributliste> [ASC | DESC]]
[LIMIT Zahl [[OFFSET Zahl]]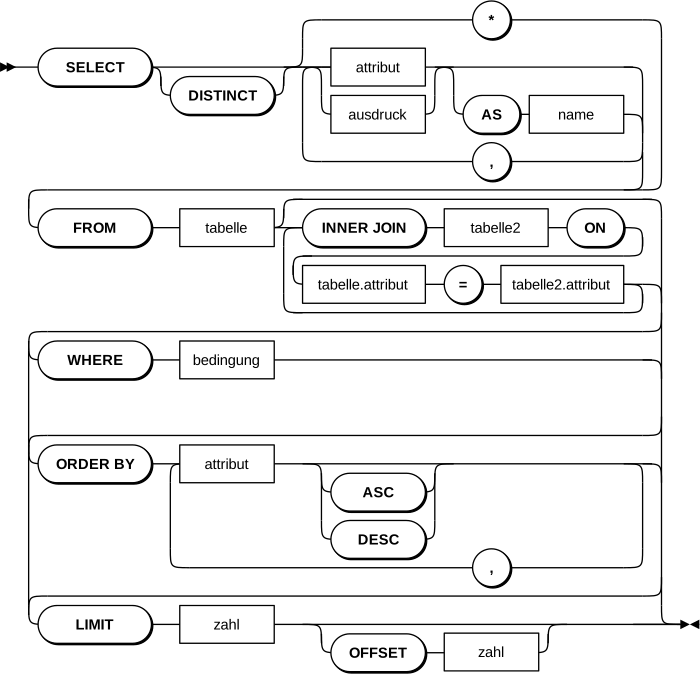
Die schwierige Syntax lässt sich wie folgt verstehen:
Klausel Erläuterung SELECT [DISTINCT] Wähle die Werte aus der/den Spalte [mehrfache Datensätze nur einmal] ... FROM ... aus der Tabelle bzw. den Tabellen ... WHERE ... wobei die Bedingung(en) erfüllt sein soll(en) ... ORDER BY [ASC/DESC] ... und sortiere nach den Spalten [auf- bzw. absteigend] ... LIMIT ... und zeige nur eine bestimmte Anzahl von Datensätze an. LK: SELECT-Befehl
Die SQL-Abfrage erfolgt mit dem Befehl SELECT unter Angabe von bis zu sieben Komponenten. Die allgemeine Syntax hat die Gestalt:
SELECT [DISTINCT] * | <Attributliste>
FROM <Tabelle oder Verbund>
[WHERE <Boolescher Ausdruck]
[GROUP BY <Attributliste>]
[HAVING <Bedingung>]
[ORDER BY <Attributliste> [ASC | DESC]]
[LIMIT Zahl [[OFFSET Zahl]]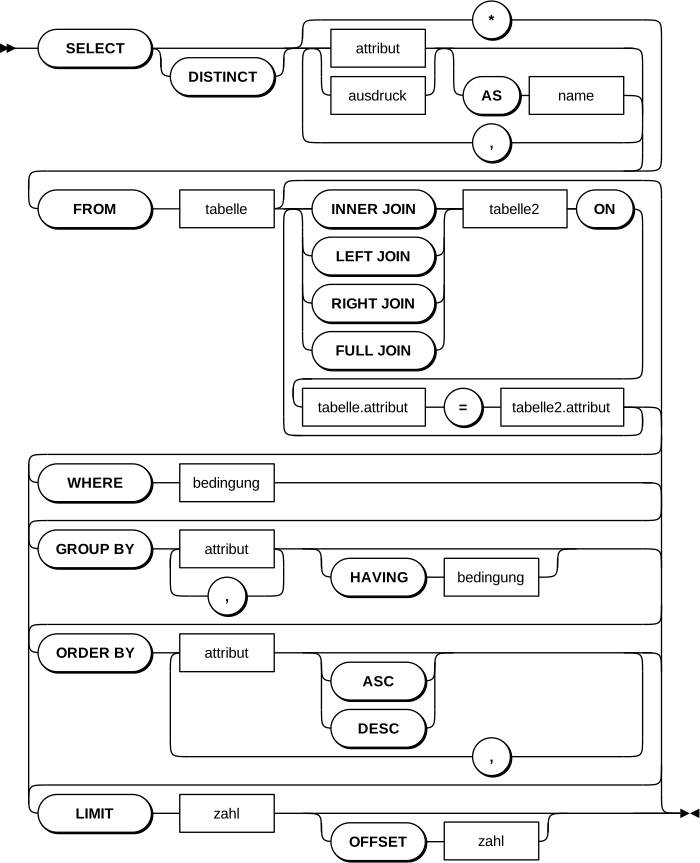
Die schwierige Syntax lässt sich wie folgt verstehen:
Klausel Erläuterung SELECT [DISTINCT] Wähle die Werte aus der/den Spalte [mehrfache Datensätze nur einmal] ... FROM ... aus der Tabelle bzw. den Tabellen ... WHERE ... wobei die Bedingung(en) erfüllt sein soll(en) ... GROUP BY ... und fasse Zeilen mit gleichen Werten der angegebenen Attribute zu Gruppen zusammen ... HAVING ... wobei darin folgende zusätzliche Bedingung(en) gelten müssen/muss ... ORDER BY [ASC/DESC] ... und sortiere nach den Spalten [auf- bzw. absteigend] ... LIMIT ... und zeige nur eine bestimmte Anzahl von Datensätze an. Auswahl von Zeilen - Selektion
Aus der Tabelle Schüler sollen alle Zeilen ausgewählt werden, in denen der Name "Müller" steht. Diese Auswahl von Zeilen entspricht in der Relationenalgebra einer Selektion.
(Die Selektion hat also die Form SName = 'Müller'(Schüler))Die Umsetzung in SQL lautet:
SELECT *
FROM Schüler
WHERE Name = 'Müller';
Schüler Ergebnis SNr Vorname Name 4711 Paul Müller 0815 Erich Schmidt 7472 Sven Lehmann 1234 Olaf Müller 2313 Jürgen Paulsen →
SNr Vorname Name 4711 Paul Müller 1234 Olaf Müller Die WHERE-Klausel liefert also die Selektion. Um zu zeigen, dass alle Spalten angezeigt werden sollen, wird das Stern-Symbol verwendet.
Nun sollen aus der Tabelle Schüler alle Zeilen selektiert werden, in denen der Name "Müller" steht und deren Vorname mit "O" beginnt.
(Die Selektion hat also die Form SName = 'Müller' UND Vorname beginnt mit 'O'(Schüler))Die Umsetzung in SQL lautet:
SELECT *
FROM Schüler
WHERE Name = 'Müller' AND Vorname LIKE 'O%';
Schüler Ergebnis SNr Vorname Name 4711 Paul Müller 0815 Erich Schmidt 7472 Sven Lehmann 1234 Olaf Müller 2313 Jürgen Paulsen →
SNr Vorname Name 1234 Olaf Müller Bedingungen lassen sich mit AND, OR und NOT verknüpfen. Das Prozentsymbol steht als Platzhalter für eine beliebige Folge von Zeichen. Das Prozentzeichen
%steht für eine beliebige Folge von Zeichen, auch für eine leere Zeichenfolge. Der Unterstrich_steht für genau ein beliebiges Zeichen. LIKE wird verwendet im Sinne von "SO WIE".Operator Erklärung =<<=>=><>Vergleicht einen Attributwert mit einem anderen Attributwert oder einer Konstanten.
gleich, kleiner als, kleiner gleich, größer gleich, größer, ungleichBETWEEN ... AND ... prüft, ob ein Attributwert zwischen zwei Grenzen einschließlich der Grenzwerte liegt IN (..., ..., ...) prüft, ob ein Attributwert in einer angegebenen Werteliste enthalten ist LIKE vergleicht Zeichenketten mit Mustern unter Verwendung der Platzhalter:
%: für beliebige Zeichen_: für genau ein ZeichenOb dabei Groß- und Kleinschreibung unterschieden werden, hängt vom verwendeten Datenbanksystem und dessen Einstellungen ab.
IS (NOT) NULL prüft, ob für ein Attribut kein Wert ( NULL) bzw. ein Wert vorhanden ist.Auswahl von Spalten - Projektion
Aus der Tabelle Schüler sollen nur die Spalte mit dem Attribut "Name" ausgewählt werden. Diese Auswahl von Spalten entspricht in der Relationenalgebra einer Projektion.
(Die Projektion hat also die Form PName(Schüler))Die Umsetzung in SQL lautet:
SELECT Name
FROM Schüler;
Schüler Ergebnis SNr Vorname Name 4711 Paul Müller 0815 Erich Schmidt 7472 Sven Lehmann 1234 Olaf Müller 2313 Jürgen Paulsen →
Name Müller Schmidt Lehmann Müller Paulsen Mit
DISTINCTwerden Mehrfachvorkommen entfernt.Die Umsetzung in SQL lautet:
SELECT DISTINCT Name
FROM Schüler;
Schüler Ergebnis SNr Vorname Name 4711 Paul Müller 0815 Erich Schmidt 7472 Sven Lehmann 1234 Olaf Müller 2313 Jürgen Paulsen →
Name Müller Schmidt Lehmann Paulsen Hintereinanderausführung von Projektion und Selektion
Aus der Tabelle Schüler sollen die Vornamen aller Schüler angezeigt werden, deren Nachname Müller ist.
(Die Abfrage hat also die Form PVorname(SName = 'Müller'(Schüler)))Die Umsetzung in SQL lautet:
SELECT Vorname
FROM Schüler
WHERE Name = 'Müller';
Schüler Ergebnis SNr Vorname Name 4711 Paul Müller 0815 Erich Schmidt 7472 Sven Lehmann 1234 Olaf Müller 2313 Jürgen Paulsen →
Vorname Paul Olaf In der zugehörigen Relationenalgebra wird zunächst die Selektion und anschließend die Projektion ausgeführt. Auch bei SQL wird logisch zunächst festgelegt, aus welchen Daten (
FROM) und unter welchen Bedingungen (WHERE) Zeilen berücksichtigt werden. Erst anschließend bestimmtSELECT, welche Spalten im Ergebnis erscheinen.Inner Join in SQL
Die Tabellen
SchülerundKursesollen über das gemeinsame AttributSNrmiteinander verbunden werden. Im Ergebnis erscheinen nur die Kombinationen von Zeilen, für die die angegebenen Werte vonSNrübereinstimmen.
(Die Abfrage hat also die Form JSchüler.SNr = Kurs.SNr(Schüler, Kurse))Die Umsetzung in SQL lautet:
SELECT *
FROM Schüler INNER JOIN Kurse
  ON Schüler.SNr = Kurse.SNr;
Schüler Kurse Ergebnis SNr Vorname Name 4711 Paul Müller 0815 Erich Schmidt 7472 Sven Lehmann 1234 Olaf Müller 2313 Jürgen Paulsen SNr KNr Fehlzeit Punkte 0815 03 0 12 4711 03 12 03 4711 09 8 05 1234 23 3 14 →
SNr Vorname Name SNr KNr Fehlzeit Punkte 4711 Paul Müller 4711 03 12 03 4711 Paul Müller 4711 09 8 05 0815 Erich Schmidt 0815 03 0 12 1234 Olaf Müller 1234 23 3 14 Da mit
SELECT *alle Spalten beider Tabellen ausgegeben werden, erscheint das VerknüpfungsattributSNrim Ergebnis zweimal. Ein solches Ergebnis wird in der Regel nicht gewünscht. Es genügen oft nur einige Spalten des Verbundes. Existieren zu einer Zeile der ersten Tabelle mehrere passende Zeilen der zweiten Tabelle, entstehen entsprechend mehrere Ergebniszeilen.Aus den Tabellen Schüler und Kurse sollen alle Schülernamen mit ihren Fehlzeiten aufgelistet werden. Der Befehl lautet:
SELECT Schüler.Vorname, Schüler.Name, Kurse.KNr, Kurse.Fehlzeit
FROM Schüler INNER JOIN Kurse
  ON Schüler.SNr = Kurse.SNr
ORDER BY Kurse.Fehlzeit DESC;
Ergebnis Vorname Name KNr Fehlzeit Paul Müller 03 12 Paul Müller 09 8 Olaf Müller 23 3 Erich Schmidt 03 0 -
LK: SQL-Befehle zum Einfügen, Löschen und Ändern von Datensätzen
Neben Abfragen mit
SELECTkönnen mit SQL auch Datensätze eingefügt, geändert und gelöscht sowie komplette Tabellen erzeugt werden.Einfügen eines Datensatzes mit Angabe der Attribute
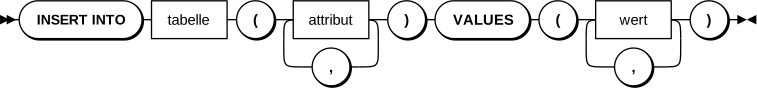
INSERT INTO tabelle (attribut1, attribut2, ...)
VALUES (wert1, wert2, ...);
Die Reihenfolge der Werte muss der Reihenfolge der angegebenen Attribute entsprechen.
Einfügen eines vollständigen Datensatzes ohne Attributliste
INSERT INTO tabelle
VALUES (wert1, wert2, ...);
Dabei müssen die Werte genau in der Reihenfolge der Attribute des Tabellenschemas angegeben werden.
Löschen von Datensätzen

DELETE FROM tabelle
WHERE bedingung;
Achtung: Fehlt die
WHERE-Klausel, werden alle Datensätze der Tabelle gelöscht.Ändern von Datensätzen
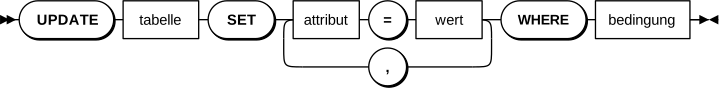
UPDATE tabelle
SET attribut1 = wert1, attribut2 = wert2, ...
WHERE bedingung;
Achtung: Fehlt die
WHERE-Klausel, wird die Änderung auf alle Datensätze der Tabelle angewendet.Erzeugen einer neuen Tabelle
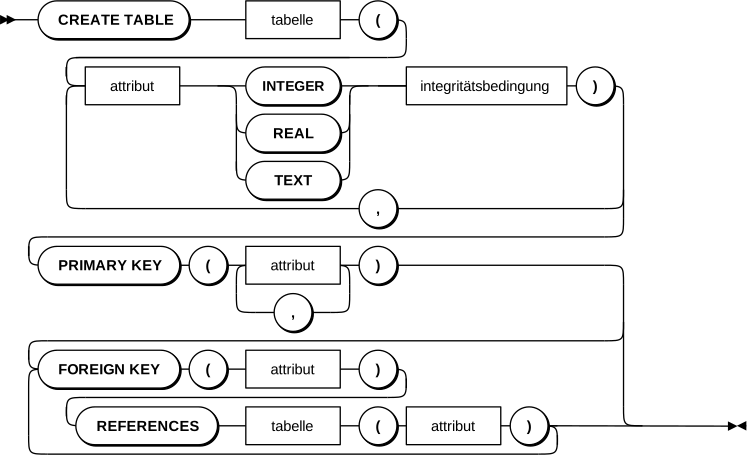
integritätsbedingungen:

CREATE tabelle (
  attribut1 TYP [integritätsbedingung],
  ...
PRIMARY KEY (attribut(e))
[FOREIGN KEY (attribut REFERENCE tabelle.attribut]
[FOREIGN KEY ...]
-
-
-
In den bisherigen Stunden haben wir Datenbanken analysiert und aus ihnen Daten abgefragt. Wir wollen nun einen Schritt weiter gehen. Liegt bereits ein relationales Datenmodell - beispielsweise als Tabelle vor, kann es durch Normalisierung schrittweise umgestaltet werden. Dabei werden vorhandene Relationen analysiert und gegebenenfalls so umstrukturiert, dass ein gut strukturiertes und redundanzarmes relationales Datenmodell entsteht. Die Grundlagen der Normalisierung gehen auf Arbeiten von Edgar F. Codd zurück.
Bildlink: © IBM, Quelle: IBM Heritage - Edgar F. Codd als Peron der Zeitgeschichte.
Anomalien und Redundanzen in nicht normalisierten Tabellen
Schauen wir uns aber zunächst an einem Beispiel an, welche Probleme in Datensammlungen auftreten können, die nicht normalisiert wurden.
Eine Schule verwaltet Lernangebote in der folgenden Relation:
SNr Name Vorname Klasse Klassenlehrer LANr Beschreibung Stunden 1 Jürgens Ina 11a Lempel 2 Tanz 12 2 Schmidt Tom 12a Breier 2, 3 Tanz, Chor 22, 8 3 Jäger Franz 11a Lempel 1, 2, 3 Elektronik, Tanz, Chor 15, 12, 2 4 Olsen Ina 11b Sommer 2 Tanz 5 5 Jürgens Paula 12a Breier 4 Töpfern 23 Welche Auswirkungen auf die Datenintegrität (Widerspruchsfreiheit) hat ...
- das Einfügen des neuen Kurses "3D-Druck":
→ Dies ist derzeit nicht möglich, da SNr Schlüssel ist. Der Kurs muss also durch einen Schüler belegt sein, um ihn einzufügen. - der Abgang/das Löschen der Schülerin Nr. 5 Paula Jürgens:
→ Dies hat zur Folge, dass neben den Schülerdaten auch die Daten des Töpferkurses gelöscht werden. - das Ändern des Namens wegen Heirat der Lehrerin Lempel zu Lempel-Schmidt:
→ Dies muss in der Tabelle mehrfach geändert werden. Werden dieselben Informationen mehrfach gespeichert, können bei Änderungen widersprüchliche Werte entstehen. Der Datenbestand ist dann inkonsistent.
Das Ändern, Einfügen und Löschen von Daten kann also zu Problemen und Fehlern führen. Man bezeichnet diese Probleme als Änderungs-, Einfüge- und Löschanomalien. Außerdem werden bestimmte Informationen mehrfach gespeichert. Solche Redundanzen können zu Inkonsistenzen führen und sollen bei der Normalisierung soweit sinnvoll reduziert werden.
- Änderungsanomalie: Dieselbe Information ist mehrfach gespeichert und wird nicht an allen Stellen gleichzeitig geändert.
- Einfügeanomalie: Eine Information kann nicht gespeichert werden, ohne zugleich weitere, eigentlich unabhängige Daten einzutragen.
- Löschanomalie: Beim Löschen eines Datensatzes geht unbeabsichtigt zusätzliche Information verloren.
- das Einfügen des neuen Kurses "3D-Druck":
-
Prozess der Normalisierung
Um unnötige Redundanzen zu reduzieren und Anomalien zu vermeiden, werden Relationen schrittweise normalisiert. Im Unterricht betrachten wir die ersten drei Normalformen.
In unserem Fall liegt nur die Relation Lernangebotsübersicht vor:
SNr Name Vorname Klasse Klassenlehrer LANr Beschreibung Stunden 1 Jürgens Ina 11a Lempel 2 Tanz 12 2 Schmidt Tom 12a Breier 2, 3 Tanz, Chor 22, 8 3 Jäger Franz 11a Lempel 1, 2, 3 Elektronik, Tanz, Chor 15, 12, 2 4 Olsen Ina 11b Sommer 2 Tanz 5 5 Jürgens Paula 12a Breier 4 Töpfern 23 1. Normalform
Eine Relation befindet sich in der ersten Normalform (1. NF), wenn jeder Attributwert atomar ist.
Ein Attributwert ist atomar, wenn er im verwendeten Datenmodell als einzelner, nicht weiter zu zerlegender Wert behandelt wird. Mehrere Werte in einem Attribut erschweren zudem die eindeutige Zuordnung zusammengehöriger Angaben.Mehrfachwerte werden so aufgelöst, dass jedes Tabellenfeld nur noch einen einzelnen Wert enthält. Dazu können beispielsweise zusätzliche Zeilen gebildet oder die betreffenden Daten in eine eigene Relation ausgelagert werden.
Relation Lernangebotsübersicht kann durch Hinzufügen von Zeilen (oder durch Auslagern der nichtatomaren Attribute mit dem vorhandenen Schlüssel) in eine neue Relation in die erste Normalform überführt werden:
SNr Name Vorname Klasse Klassenlehrer LANr Beschreibung Stunden 1 Jürgens Ina 11a Lempel 2 Tanz 12 2 Schmidt Tom 12a Breier 2 Tanz 22 2 Schmidt Tom 12a Breier 3 Chor 8 3 Jäger Franz 11a Lempel 1 Elektronik 15 3 Jäger Franz 11a Lempel 2 Tanz 12 3 Jäger Franz 11a Lempel 3 Chor 2 4 Olsen Ina 11b Sommer 2 Tanz 5 5 Jürgens Paula 12a Breier 4 Töpfern 23
Beobachtungen:-
- Die Herstellung der 1. Normalform beseitigt die Mehrfachwerte, kann aber zunächst zu zusätzlichen Redundanzen führen.
- Nach dem Aufteilen ist
SNrallein nicht mehr als Primärschlüssel geeignet, da eine Schülernummer mehrfach vorkommen kann. Die Kombination ausSNrundLANrkann die Zeilen eindeutig identifizieren und bildet daher einen zusammengesetzten Schlüssel.
2. Normalform
Eine Relation befindet sich in der zweiten Normalform, falls
-
- die Relation in der ersten Normalform ist und
- jedes Nichtschlüsselattribut voll funktional vom gesamten Primärschlüssel abhängig ist.
Regel zum Prüfen der zweiten Bedingung:
Voll funktional abhängig bedeutet: Kein Nichtschlüsselattribut darf bereits von einem echten Teil des zusammengesetzten Schlüssels abhängen. Hängt mindestens ein Nichtschlüsselattribut funktional nur von einem Teil des zusammengesetzten Schlüssels ab, liegt keine 2. Normalform vor.Schrittfolge zur Herstellung der zweiten Normalform:
-
- Festlegen/Feststellen des Primärschlüssel
→ Falls dieser nur aus einem Attribut besteht, so liegt 2. NF vor. - Untersuchen, ob aus Teilschlüsselattributen bereits weitere Attribute folgen.
→ Falls dies nicht der Fall ist, so liegt die 2. NF vor.
→ Falls dies der Fall ist, so Schritt 3. - Für jeden Teilschlüssel, von dem Nichtschlüsselattribute funktional abhängen, wird eine eigene Relation gebildet. Der Teilschlüssel wird Primärschlüssel dieser neuen Relation.
- Löschen der ausgelagerten Nichtschlüsselattribute in der Ausgangsrelation.
- Wiederholen des Vorgangs ab Schritt 2, bis alle Nichtschlüsselattribute vom gesamten Schlüssel funktional abhängig sind.
- Festlegen/Feststellen des Primärschlüssel
In der Relation Lernangebotsübersicht ist die Attributkombination SNr und LANr der neue Primärschlüssel. Aus dem Teilschlüssel LANr lässt sich bereits eindeutig auf das Attribut "Beschreibung" schließen. Aus SNr lässt sich eindeutig auf die Attribute "Name", "Vorname", "Klasse" und" Klassenlehrer" schließen. Somit sind zwei neue Relationsschemen Lernangebot und Schüler zu erzeugen und das verbleibende Schema Lernangebotsübersicht umzubenennen und so zu überarbeiten, dass die Attribute "Beschreibung", "Name", "Vorname", "Klasse" und "Klassenlehrer" gelöscht werden. Das Attribut
Stundenbleibt in der RelationTeilnahme, da sein Wert erst durch die Kombination aus Schüler und Lernangebot bestimmt wird.
Relation Lernangebot Relation Schüler Relation Teilnahme LANr Beschreibung 1 Elektronik 2 Tanz 3 Chor 4 Töpfern SNr Name Vorname Klasse Klassenlehrer 1 Jürgens Ina 11a Lempel 2 Schmidt Tom 12a Breier 3 Jäger Franz 11a Lempel 4 Olsen Ina 11b Sommer 5 Jürgens Paula 12a Breier ↑SNr ↑LANr Stunden 1 2 12 2 2 22 2 3 8 3 1 15 3 2 12 3 3 2 4 2 5 5 4 23 Beobachtung: Die Beschreibung eines Lernangebots wird nun nur noch einmal gespeichert. Ebenso werden die Stammdaten eines Schülers nicht mehr für jedes belegte Lernangebot wiederholt.
3. Normalform
Eine Relation befindet sich in der dritten Normalform, falls
-
- die Relation in der zweiten Normalform ist und
- kein Nichtschlüsselattribut transitiv vom Primärschlüssel abhängt.
Eine transitive Abhängigkeit liegt beispielsweise vor, wenn ein Nichtschlüsselattribut ein anderes Nichtschlüsselattribut bestimmt.
Regel zum Prüfen der zweiten Bedingung:
Hängt ein Nichtschlüsselattribut von einem anderen Nichtschlüsselattribut ab und dadurch nur transitiv vom Primärschlüssel, liegt keine 3. NF vor!Schrittfolge zur Herstellung der dritten Normalform:
-
- Untersuchung, ob aus Nichtschlüsselattributen andere Nichtschlüsselattribute folgen.
→ Falls dies nicht der Fall ist, so liegt bereits die 3. NF vor.
→ Falls dies der Fall ist, so Schritt 2. - Bilden einer neuen Relation aus dem bestimmenden Nichtschlüsselattribut und den von ihm funktional abhängigen Attributen. Das bestimmende Attribut wird Primärschlüssel der neuen Relation.
- Löschen der ausgelagerten Nichtschlüsselattribute mit Ausnahme des Attributes, das in der neuen Relation Primärschlüssel ist.
- Wiederholen des Vorgangs ab Schritt 1, bis keine Abhängigkeiten mehr bestehen.
- Untersuchung, ob aus Nichtschlüsselattributen andere Nichtschlüsselattribute folgen.
In den Relationen Teilnahme und Lernangebot kann keine transitive Abhängigkeit zwischen Nichtschlüsselattributen auftreten, da jeweils nur ein Nichtschlüsselattribut vorhanden ist. Beide Relationen befinden sich daher bereits in der 3. NF. In der Relation Schüler folgt aus dem Nichtschlüsselattribut "Klasse" jedoch der "Klassenlehrer". Somit ist eine neue Relation Klassenübersicht mit den Attributen "Klasse" (Primärschlüssel) und "Klassenlehrer" zu erzeugen und das verbleibende Schema Schüler so zu überarbeiten, dass das Attribut "Klassenlehrer" gelöscht wird.

Relation Lernangebot Relation Schüler Relation Teilnahme Relation Klassenübersicht LANr Beschreibung 1 Elektronik 2 Tanz 3 Chor 4 Töpfern SNr Name Vorname ↑Klasse 1 Jürgens Ina 11a 2 Schmidt Tom 12a 3 Jäger Franz 11a 4 Olsen Ina 11b 5 Jürgens Paula 12a ↑SNr ↑LANr Stunden 1 2 12 2 2 22 2 3 8 3 1 15 3 2 12 3 3 2 4 2 5 5 4 23 Klasse Klassenlehrer 11a Lempel 11b Sommer 12a Breier -
-
01 AB Normalisierung Lösungen Datei
-
01 Normalisierungsablauf Lösung Datei
-
-
-
Beispiel
Für jeden Schüler werden jährlich die Stammdaten (Name, Vorname, Geburtsdatum, Anschrift, Telefon) erfasst bzw. kontrolliert. Die Eingabe der Daten erfolgt durch das Sekretariat. Die Grunddaten benötigen aber auch:
- der Koordinator der Sekundarstufe II, um das Kurssystem aufzubauen,
- der Koordinator der Sekundarstufe I, um die WPU-Kurse zu planen,
- die Schülerbibliothek, um die Leihlisten zu aktualisieren,
- der Schuladministrator, um die Schüleraccounts zu erstellen.
Jede beteiligte Stelle erhielt eine eigene Kopie der benötigten Schülerdaten. Damit konnte er auf diese zugreifen und Veränderungen in ihnen vornehmen. Ging ein Schüler vom Gymnasium ab, so konnte es passieren, dass seine Daten nur im Sekretariat gelöscht wurden. Die übrigen Datenkopien wurden dadurch jedoch nicht automatisch aktualisiert.
Es ergab sich folgende Datennutzungsstruktur:
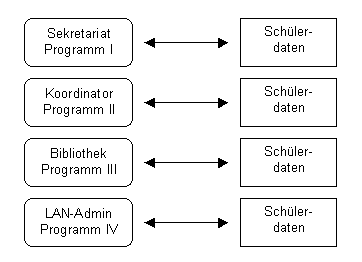
-
Nachteile einer solchen Datenverwaltung:
- starke Datenredundanz, d. h. dieselben Daten werden mehrfach gespeichert
- nach längerer Zeit erhöhte Dateninkonsistent, d. h. Widersprüchlichkeit zwischen den Datensammlungen
- Unflexibel beim Einarbeiten von Änderungen, d. h. Änderungen müssen für jeden Nutzer vorgenommen werden
- verminderter Datenschutz und geringe Datensicherheit, d. h. Nutzer erhalten Daten, deren Einsicht für sie nicht zulässig ist, Datendiebstahl wird vereinfacht
- keine Standards, d. h. jedes Programm verwaltet die Daten anders
Datenverwaltung optimal/heute
In der vernetzten Schule gibt es die Schülerdaten nur einmal. Die einzelnen Anwender/Programme greifen nach Prüfung der Befugnis über das Datenbankmanagementsystem (DBMS) logisch auf die Datenbasis zu und erhalten eine eingeschränkte, auf ihre Aufgaben zugeschnittene Sicht auf die Daten. Eine direkte Manipulation der Daten ist nicht mehr möglich. Das DBMS überwacht die Zugriffe.
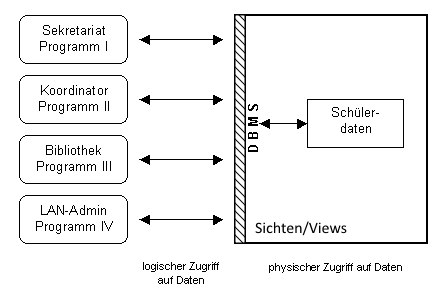
Ein solcher Aufbau ist sinnvoll und dient als Modell für den allgemeinen Aufbau eines Datenbanksystems.
Grundsätzlicher Aufbau von Datenbanksystemen
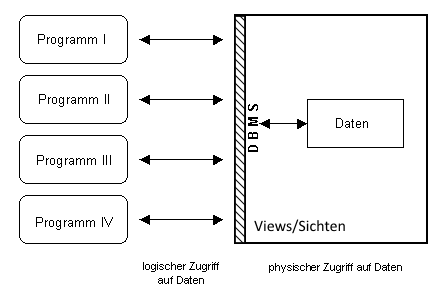
Ein Datenbanksystem (DBS) setzt sich aus einer Datenbasis und einem Datenbankmanagementsystem (DBMS) zusammen. Es ist die Software zur Definition, Verwaltung, Änderung und Abfrage der Daten. Es vermittelt den Zugriff von Anwendungen und Benutzern auf die Datenbank und dient der effizienten Speicherung und Abfrage der strukturierten Daten. Die Datenbank enthält neben den reinen Nutzdaten auch die zur Verwaltung des gesamten Systems nötigen Metadaten. Metadaten beschreiben beispielsweise Tabellen, Attribute, Datentypen, Schlüssel und Zugriffsrechte.
Kriterien/Anforderungen an DBS
Aus dem formalen Aufbau von Datenbanksystemen ergeben sich Eigenschaften, die gleichzeitig Kriterien für ein gute DBS sind:
- Datenkonsistenz:
gespeicherten Daten dürfen sich nicht gegenseitig widersprechen - Datenintegrität
durch festgelegte Integritätsbedingungen wird sichergestellt, dass nur zulässige Daten und Beziehungen gespeichert werden - Integritätsbedingungen tragen dazu bei, einen konsistenten Datenbestand zu erhalten - Redundanzarmut
unnötige Mehrfachspeicherung von Datenwerten wird vermieden - Datensicherheit
Technische und organisatorische Maßnahmen schützen Daten vor Verlust, Beschädigung und unberechtigter Veränderung oder Nutzung - Datenschutz
Personenbezogene Daten dürfen nur entsprechend den geltenden Regeln und Berechtigungen verarbeitet werden. Zugriffsrechte und Sichten können dies technisch unterstützen. - Mehrbenutzerbetrieb
Mehrere Benutzer können gleichzeitig auf die Datenbank zugreifen. Das DBMS koordiniert konkurrierende Zugriffe und sorgt dafür, dass Änderungen kontrolliert verarbeitet werden - Datenunabhängigkeit
die Art der internen Speicherung der Daten kann verändert werden, ohne dass Anwendungen und Benutzer ihre Arbeitsweise entsprechend ändern müssen - zentrale Kontrolle
Strukturen, Zugriffsrechte, Integritätsregeln und Sicherungsmaßnahmen können für die gesamte Datenbank zentral verwaltet werden
-
- Diskutieren Sie Nachteile der obigen Struktur. Leiten Sie Schlussfolgerungen ab.
- Beurteilen Sie die beiden Ansätze zur Speicherung von Daten einer Surfschule (S. 390f. Aufgabe 1-4) sowie eines Online-Buchhandels (S. 298). Leiten Sie Schlussfolgerungen für gute Datenbankensysteme ab.
-
Behauptung: Datenbanksystem bestehen aus einer Mehr-Schicht-Architektur und bieten exzellente Möglichkeiten zum Speichern und Verwalten umfangreicher Datenmengen.
Informieren Sie sich (in zwei Gruppen) im Lehrbuch Schöningh "Informatik 2" Kapitel 7.1 ab Seite 293 unten und 7.2 ab Seite 298 (ab Zwischenüberschrift ) bzw. im Lehrbuch HeLP "Datenbanken - Informatik für die Sekundarstufe II" Kapitel 2.1 über Datenbanksysteme. Ermitteln Sie Aspekte, die die Behauptungen untermauern. Stellen Sie diese unter Verwendung der u. g. Bereiche in einer Lernübersicht dar.
- Aufbau, Zugriff und Bestandteile (incl. Aufgaben der Teile) eines Datenbanksystems
- Anforderungen an Datenbanksysteme:
Datenkonsistenz, Datenintegrität, Redundanzarmut, Datensicherheit, Datenschutz, Mehrbenutzerbetrieb, Datenunabhängigkeit, zentrale Kontrolle
-
Etappen für den Entwurf eines Datenbanksystems
Die systematische Entwicklung eines Datenbanksystems erfolgt in Schritten, deren korrekte Ausführung maßgeblich über die Qualität des Endprodukts entscheidet. Im Allgemeinen ist folgender Ablauf notwendig:
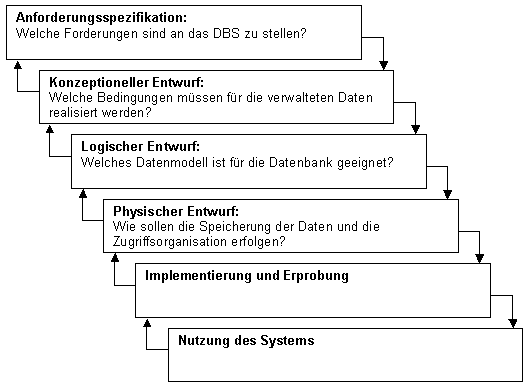
Diese Schritte werden gern in drei Phasen/Etappen zusammengefasst.
Anforderungsspezifikation und
konzeptionelle Entwurfsetappe→
logische Entwurfsetappe
→
physischer Entwurf und Implementierung
- IST-Analyse: Untersuchung der vorhandenen Situation und Datenverarbeitung
- SOLL-Konzept: Festlegung der Anforderungen an das zu entwickelnde Datenbanksystem.
- Abbildung des relevanten Realitätsausschnitts in einem vom DBMS unabhängigen Modell. Dabei werden Objekte und ihre Beziehungen zu Entitätstypen und Beziehungstypen abstrahiert.
- Überführung des ER-Modells in das relationale Datenmodell mithilfe eines Regelsystems
- Festlegung von Primärschlüssel- und Fremdschlüsselattributen
- Festlegung geeigneter Datentypen und Integritätsbedingungen
- Festlegung von Sichten und Zugriffsrechten zur Sicherstellung des Datenschutzes und der Datensicherheit
- Implementierung im DBMS
- Erfassung von Grunddaten
Entity-Relationship-Modell (ER-Modell)
relationales Datenbankschema aus mehreren Relationenschemata
implementierte Datenbank im gewählten DBMS
Nicht verwechseln: Die drei Entwicklungsphasen beschreiben den Weg von den Anforderungen bis zur implementierten Datenbank. Die drei Schichten beschreiben verschiedene Abstraktionsebenen eines Datenbanksystems: Benutzersicht, logisches Datenmodell und interne Realisierung.
-
-
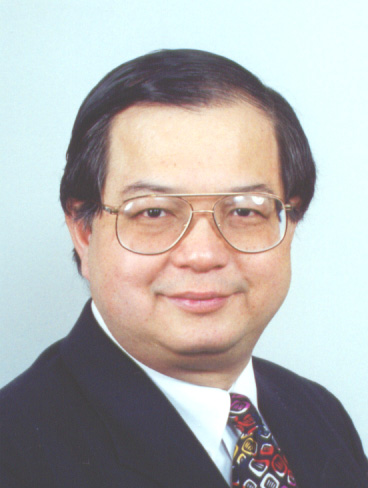 Das Entity-Relationship-Modell wurde 1976 vom taiwanischen Informatiker Peter Chen vorgestellt. Das Modell dient der konzeptionellen Modellierung von Daten und ihren Beziehungen und wird insbesondere beim Entwurf von Datenbanken eingesetzt. Chen zählt zu den Pionieren der Informatik.
Fotolink aus der Website von Peter Chen als Person der Zeitgeschichte
-
Entität, Attribut, Attributwert, Entitätstyp und Schlüssel
Eine Entität ist ein eindeutig identifizierbares konkretes oder abstraktes Objekt des betrachteten Realitätsausschnitts, beispielsweise
- der Schüler Karl Meier aus der Klasse 7a,
- mein Fahrrad der Marke Mifa,
- mein Exemplar des Buches "Abenteuer Informatik",
- Konrad Zuses Computer Z3.
Entitäten werden durch Attribute beschrieben. Für eine konkrete Entität besitzen diese Attribute bestimmte Attributwerte. Bei der späteren Umsetzung in einer relationalen Datenbank können fehlende oder unbekannte Werte durch
NULLdargestellt werden.Entität: Schüler Karl Meier aus der Klasse 7a
Attribut mit Wert: Name = Meier, Vorname = Karl, Wohnort = Hohenwulsch, Schule = Dorfschule, Klasse = 7a, Telefon = NULL, ...Ein Entitätstyp ist eine abstrakte Beschreibung einer Menge von Entitäten mit gleichen Attributen. Eine Entität ist ein eindeutig identifizierbares Element des Entitätstyps. Ein Entitätstyp wird durch seinen Namen und seine Attribute beschrieben.
Karl Meier könnte eine Entität des Entitätstyps Schüler sein.
Seine Attribute Name und Vorname werden durch die Werte Meier bzw. Karl belegt.
Objektorientierte Darstellung: Schüler.Name = "Meier"
Im Entity-Relationship-Diagramm (ER-Diagramm) wird der Entitätstyp durch ein Rechteck dargestellt und beschriftet. Die Attribute werden i. d. R. durch Ovale dargestellt, die eine Verbindung zum Entitätstyp haben.

Besonderheiten bei Attributen:
- (Teil-) Schlüsselattribut – Unterstreichung:
Ein Schlüssel ist eine minimale Kombination von Attributen, durch deren Werte jede Entität eindeutig identifiziert wird. Schlüsselwerte müssen eindeutig sein und sollten möglichst stabil bleiben. Besteht der Schlüssel aus genau einem Attribut, spricht man von einem einfachen Schlüssel. Besteht er aus mehreren Attributen, handelt es sich um einen zusammengesetzten Schlüssel. Die einzelnen Attribute eines zusammengesetzten Schlüssels werden als Teilschlüsselattribute bezeichnet - Zusammengesetztes Attribut – Verbindung von Attribut zu Attribut:
Ein zusammengesetztes Attribut kann in Teilattribute zerlegt werden. So kann beispielsweise die Anschrift in PLZ, Ort, Straße und Hausnummer zerlegt werden.
Beziehung, Beziehungstyp und Kardinalität
Zwischen Entitäten können vielfältige Beziehungen bestehen, beispielsweise kann Lehrer Lempel der Klassenlehrer des Schülers Paul Meyer sein. Eine Beziehung verknüpft Entitäten miteinander. Sie kann aus der Sicht der beteiligten Entitätstypen beschrieben werden. Für das Beispiel gilt dann:
Sicht 1: der Lehrer Lempel unterrichtet den Schüler Karl Meyer.
Sicht 2: der Schüler Karl Meyer wird von Lehrer Lempel unterrichtet.
Im Rahmen dieses Kurses betrachten wir nur binäre Beziehungen, die jeweils eine Entität eines Entitätstyps mit einer Entität eines anderen – oder auch desselben – Entitätstyps verknüpfen. Ein Beziehungstyp beschreibt gleichartige Beziehungen zwischen Entitäten bestimmter Entitätstypen. Ein Beziehungstyp kann Attribute besitzen. Ob ein Sachverhalt zweckmäßiger als Entitätstyp oder als Beziehungstyp modelliert wird, hängt von den Anforderungen des betrachteten Realitätsausschnitts ab. Hier muss der Datenbankmodellierer angemessen entscheiden. Für die Darstellung von Beziehungstypen nutzt man das Rautensymbol und notiert darin den Namen des Beziehungstyps – möglichst als Verb.

Die Kardinalität trifft eine Aussage über die maximale Anzahl der an einer Beziehung beteiligten Entitäten. Für die Datenstrukturierung interessieren nicht die genauen Zahlen, sondern nur die Angaben "höchstens eine Entität (1)" oder "beliebig viele Entitäten (n oder m)". Da der Beziehungstyp wechselseitig ist, wird die Kardinalität durch zwei Angaben vollständig beschrieben.
a) Ein Schüler geht in höchstens eine Klasse.
b) Eine Klasse besteht aus mehreren Schülern.
Es gibt drei Kombinationen, die wir in der Chen-Notation angeben:
- 1:1: Ein Raum ist Klassenraum für höchstens eine Klasse. Eine Klasse hat höchstens einen Raum als Klassenraum.

- 1:n: Ein Schüler geht in höchstens eine Klasse. Eine Klasse besteht aus mehreren Schülern.

- n:m: Ein Lehrer unterrichtet mehrere Klassen. Eine Klasse wird von mehreren Lehrern unterrichtet.

-
-
-
SQLite als gewähltes Datenbanksystem
Vor der Implementierung der Tabellen des relationalen Modells in einem Datenbanksystem wird jedem Attribut ein geeigneter Datentyp zugeordnet. Zusätzliche Festlegungen können den zulässigen Wertebereich einschränken und damit zur Sicherung der Datenintegrität beitragen.
Datentypen
Wir unterscheiden zwischen den Datentypen (siehe auch SQLite-Dokumentation)
- INTEGER – vorzeichenbehaftete Ganzzahl, gespeichert in maximal 8 Byte,
- REAL – vorzeichenbehaftete Gleitkommazahl, gespeichert als 8-Byte-Gleitkommewert nach IEEE 754,
- TEXT – Zeichenkette, gespeichert in einer von SQLite unterstützten Unicode-Kodierung,
- BLOB – folge von binären Daten, die unverändert gespeichert werden.
SQLite besitzt keine eigenen Speicherklassen für Datums-, Zeit- oder Wahrheitswerte. Solche Werte werden mithilfe der vorhandenen SQLite-Datentypen gespeichert. Bei der Dateneingabe sind Schreibweisen einzuhalten.
- DATE – zweckmäßig als TEXT in der Form 'YYYY-MM-DD'
- TIME – zweckmäßig als TEXT in der Form 'HH:MM:SS'
- DATETIME – zweckmäßig als TEXT in der Form 'YYYY-MM-DD HH:MM:SS'
- BOOLEAN – üblicherweise als INTEGER mit den Werten 0 und 1
Wertebereichsintegrität
Bei der Definition von Attributen sind Wertebereichseinschränkungen und Vorgabewerte möglich, beispielsweise
- NULL/Nicht NULL: legt fest, ob ein fehlender Wert zulässig ist,
- Eindeutigkeit (UNIQUE): Attributwert muss über alle Datensätze hinweg eindeutig sein,
- Standard (DEFAULT): Vorgabe eines Standardattributwertes, der verwendet wird, wenn beim Einfügen kein anderer Wert angegeben wird,
- Zustandsprüfung (CHECK): Festlegung einer Bedingung, die ein einzutragender oder geänderter Wert erfüllen muss in Analogie zur WHERE-Klausel bei SQL-Abfragen.
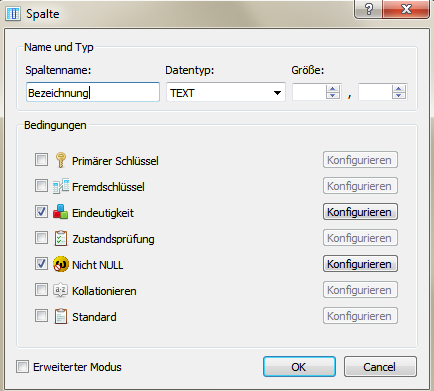
Bild: Festlegung der Attributeigenschaften in SQLiteStudioFestlegung von Primär- und Fremdschlüsseln
Besteht der Primärschlüssel aus genau einem Attribut, erfolgt diese Festlegung bei der Definition des Attributs durch die Option Primärer Schlüssel. Weitere Optionen (AUTOINCREMENT, Sortierung) sind möglich.
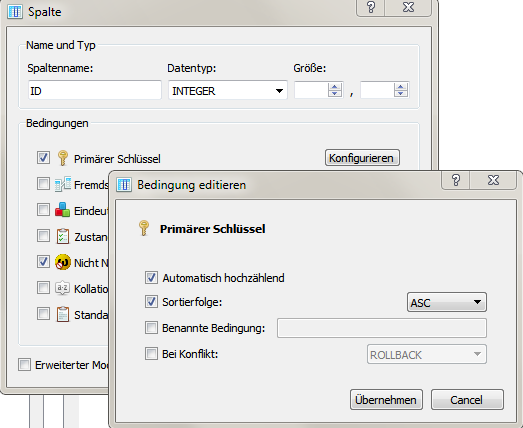
Bild: Festlegung zusätzlicher Primärschlüsseleigenschaften in SQLiteStudioLiegt ein zusammengesetzter Primärschlüssel vor, so sind die einzelnen Attribute ohne die Aktivierung der Option Primärer Schlüssel festzulegen. Anschließend wird unter Bedingungen der zusammengesetzte Primärschlüssel festgelegt.

Bild: Definition eines zusammengesetzten Primärschlüssels mittels Bedingungsdefinition in SQLiteStudioDem Fremdschlüsselattribut wird die referenzierte Tabelle mit dem zugehörigen Schlüsselattribut zugeordnet..
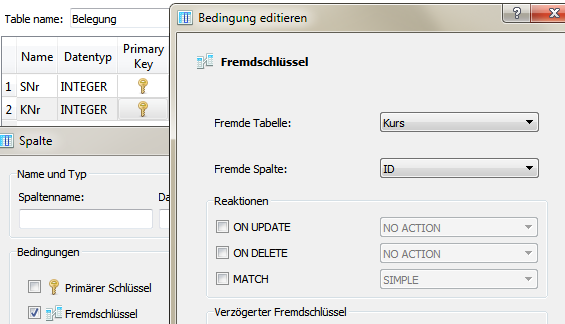
Bild: Festlegung der Fremdschlüsseleingeschaft und Setzen des Verweises in die Fremdtabelle in SQLiteStudioUnter Reaktionen sollte festgelegt werden, was beim Ändern/Löschen eines Datensatzes geschieht. Es gilt dabei:
- NO ACTION: Die Änderung bzw. Löschung wird nicht zugelassen, wenn dadurch ein ungültiger Fremdschlüsselverweis entstehen würde
- CASCADE: Änderungen des referenzierten Schlüsselwertes bzw. Löschungen werden auf die abhängigen Fremdschlüssel-Datensätze übertragen
- RESTRICT: Die Änderung oder Löschung des referenzierten Datensatzes wird verhindert, solange abhängige Datensätze vorhanden sind
- SET NULL/DEFAULT: Der Fremdschlüssel abhängiger Datensätze wird auf
NULLbzw. den definierten Standardwert gesetzt. Dies ist nur möglich, wenn diese Werte zulässig sind
-
-
-
Hinweis für Nachnutzer: Für den Einsatz im Unterricht muss eine Vorführlizenz bei Schulfilme-Online erworben werden.